2과목 소프트웨어 개발은 자료 구조 계산 문제와 테스트 이론이 절반 이상입니다. 트리 순회와 후위 표기법은 직접 손으로 풀 줄 알아야 하고, 테스트·품질·형상 관리는 두문자로 끝나는 파트예요.
이 글 하나로 끝낼 수 있게 용어마다 뜻과 예시를 같이 적고, 트리 순회 결과와 정렬 1회전 결과는 실제로 계산한 값을 넣었습니다. 트리 순회, V-모델, 통합 테스트는 그림으로도 정리했어요.
※ 2026년 9월 기준 정보처리기사 필기 출제기준(5과목 체계)에 맞춰 정리했습니다. 응시 자격·과목 구성·공부 순서는 정보처리기사 시험 과목 총정리 글에서 볼 수 있어요.
이 글의 순서
- 핵심 암기 키워드 한눈에 보기
- 자료 구조와 알고리즘
- 애플리케이션 테스트
- 품질 · 형상 관리 · 인터페이스
- 헷갈리지 않게 외우는 요령
- A4 한 장 요약본
1. 핵심 암기 키워드 한눈에 보기
키워드만 보고 오른쪽 내용이 바로 떠오르면 통과입니다. 막히는 항목만 아래 본문에서 다시 보세요.
| 항목 | 암기 키워드 | 풀어 쓰면 |
| 자료 구조의 분류 | 선형 / 비선형 | 선형: 배열 · 리스트 · 스택 · 큐 · 데크 / 비선형: 트리 · 그래프 |
| 스택과 큐 | LIFO · FIFO | 스택 LIFO(함수 호출 · 후위식 · DFS) / 큐 FIFO(스케줄링 · BFS) |
| 트리 순회 | 루트를 언제 방문하나 | 전위 Root-L-R / 중위 L-Root-R / 후위 L-R-Root |
| 수식 표기법 변환 | 괄호로 묶고 연산자 이동 | 우선순위대로 괄호 → 후위는 연산자를 괄호 뒤로, 전위는 앞으로 |
| 정렬 알고리즘 | 삽선버 n² / 퀵힙병 n log n | 삽입·선택·버블 O(n²) · 퀵 평균 n log n / 최악 n² · 힙·합병 n log n |
| 검색과 해싱 | 이분 검색은 정렬 필수 | 이분 검색 = 정렬 필수 O(log n) · 해싱 충돌 = 같은 주소 · 체이닝 |
| 테스트 레벨과 V-모델 | 단통시인 | 단위(구현) → 통합(설계) → 시스템(분석) → 인수(요구사항) |
| 인수 테스트의 종류 | 알파 / 베타 | 알파 = 개발자 장소 + 개발자 관찰 / 베타 = 사용자 환경, 개발자 없음 |
| 통합 테스트 방식 | 상드하스 | 상향식 = 드라이버 / 하향식 = 스텁 |
| 화이트박스 테스트 | 기초 경로 · 제어 구조 | 기초 경로(순환 복잡도 E − N + 2) · 조건 · 루프 · 데이터 흐름 |
| 블랙박스 테스트 | 동경원오비 | 동치 분할 · 경계값 · 원인-효과 그래프 · 오류 예측 · 비교 |
| 테스트 오라클 | 참샘휴일 | 참 · 샘플링 · 휴리스틱(추정) · 일관성 검사 |
| ISO/IEC 9126 품질 특성 | 기신사효유이 | 기능성 · 신뢰성 · 사용성 · 효율성 · 유지보수성 · 이식성 |
| 형상 관리 | 식통감기 | 식별 → 통제 → 감사 → 기록 |
| 클린 코드 | 가단의중추 | 가독성 · 단순성 · 의존성 배제 · 중복성 최소화 · 추상화 |
| 인터페이스 구현 | 포허메하 | Point-to-Point · Hub&Spoke · Message Bus · Hybrid / JSON · XML · AJAX |
2. 자료 구조와 알고리즘
자료 구조의 분류
암기 키워드 ▸ 선형 / 비선형
| 용어 | 설명 |
| 배열 (Array) | 같은 자료형을 연속된 메모리에 저장. 인덱스로 바로 접근 가능 |
| 선형 리스트 | 연속 리스트(배열처럼 연속 저장)와 연결 리스트(포인터로 연결, 삽입·삭제가 쉬움) |
| 스택 (Stack) | 한쪽 끝에서만 넣고 빼는 구조 (후입선출) |
| 큐 (Queue) | 한쪽에서 넣고 반대쪽에서 빼는 구조 (선입선출) |
| 데크 (Deque) | 양쪽 끝 모두에서 넣고 뺄 수 있는 구조 |
| 트리 (Tree) | 부모-자식의 계층 구조. 사이클이 없음 → 비선형 |
| 그래프 (Graph) | 정점(Vertex)과 간선(Edge)의 집합. 사이클이 생길 수 있음 → 비선형 |
시험 포인트 배열·리스트·스택·큐·데크는 선형, 트리·그래프는 비선형입니다.
스택과 큐
암기 키워드 ▸ LIFO · FIFO
| 용어 | 설명 |
| 스택 (Stack) | 한쪽 끝(Top)에서만 삽입(Push)·삭제(Pop). 나중에 들어간 것이 먼저 나옴 (LIFO, 후입선출) |
| 스택의 활용 | 함수 호출 시 복귀 주소 저장, 후위 표기식 계산, 되돌리기(Undo), 깊이 우선 탐색(DFS), 인터럽트 처리 |
| 큐 (Queue) | 뒤(Rear)에서 삽입, 앞(Front)에서 삭제. 먼저 들어간 것이 먼저 나옴 (FIFO, 선입선출) |
| 큐의 활용 | CPU 작업 스케줄링, 프린터 스풀, 너비 우선 탐색(BFS) |
| 데크 (Deque) | 양쪽 끝에서 모두 삽입·삭제. 입력 제한 데크(Scroll), 출력 제한 데크(Shelf) |
예시
A, B, C 순서로 스택에 Push한 뒤 Pop을 2번 하면 C, B 순서로 나오고 A만 남습니다.
같은 순서로 큐에 넣고 2번 삭제하면 A, B 순서로 나오고 C만 남습니다.
트리 용어
| 용어 | 설명 |
| 근 노드 (Root) | 트리의 맨 위에 있는 노드 |
| 차수 (Degree) | 한 노드가 가진 자식(서브트리)의 수. 트리의 차수 = 노드 차수 중 가장 큰 값 |
| 단말 노드 (Leaf) | 자식이 없는 노드 (차수 0) |
| 레벨 / 깊이 | 근 노드를 레벨 1로 두고 아래로 셈. 트리의 깊이 = 가장 큰 레벨 |
| 이진 트리 | 모든 노드의 차수가 2 이하인 트리. 깊이가 k이면 최대 노드 수 = 2ᵏ − 1개 |
| 포화 / 완전 이진 트리 | 모든 레벨이 꽉 찬 트리 / 마지막 레벨만 빼고 꽉 차 있고, 마지막 레벨은 왼쪽부터 채운 트리 |
트리 순회
암기 키워드 ▸ 루트를 언제 방문하나
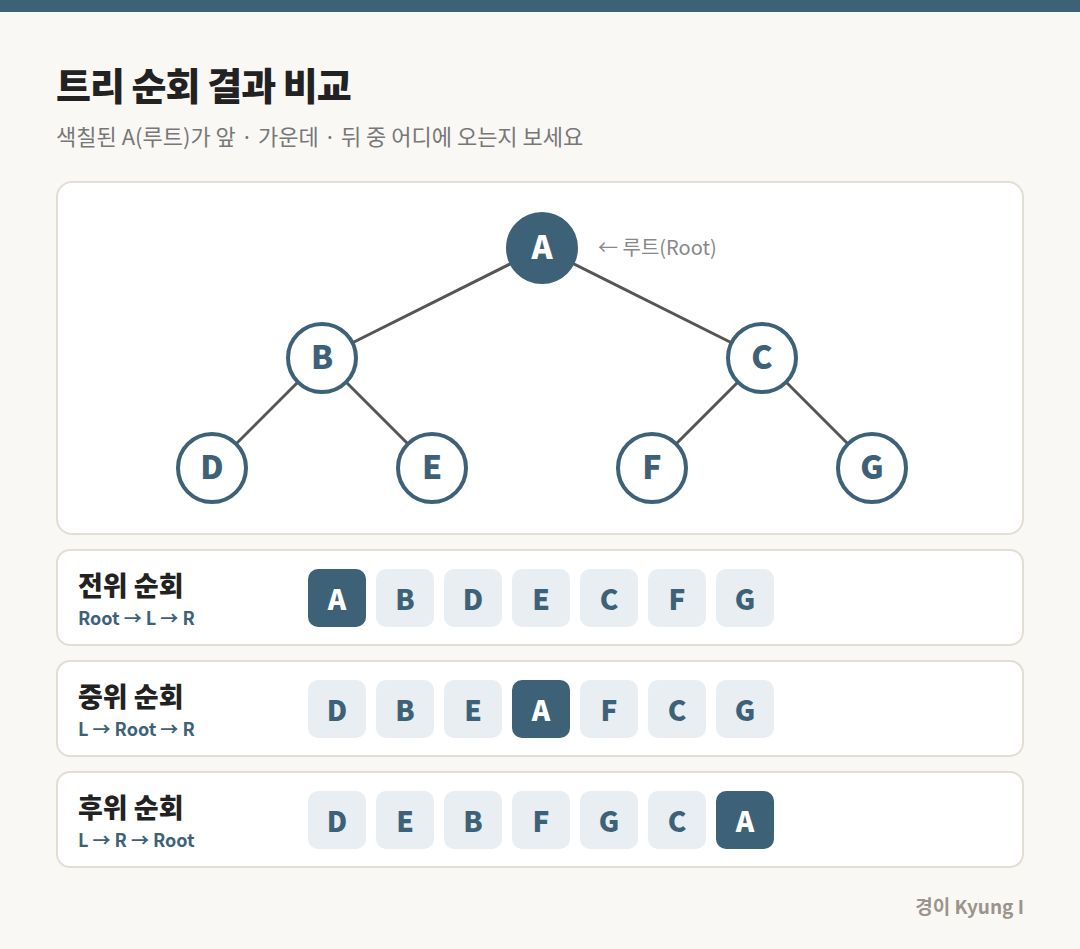
이름의 전·중·후는 '루트를 언제 방문하느냐'입니다. 왼쪽 서브트리가 항상 오른쪽보다 먼저예요.
| 용어 | 설명 |
| 전위 순회 (Preorder) | Root → Left → Right (루트를 먼저) |
| 중위 순회 (Inorder) | Left → Root → Right (루트를 가운데) |
| 후위 순회 (Postorder) | Left → Right → Root (루트를 마지막) |
예시
그림의 트리 → 전위: A B D E C F G / 중위: D B E A F C G / 후위: D E B F G C A
시험 포인트 서브트리를 한 덩어리로 보고 바깥에서 안쪽으로 풀면 실수가 줄어듭니다. 예) 전위 = A, (B 덩어리), (C 덩어리) → A, B D E, C F G
수식 표기법 변환 (중위 → 후위·전위)
암기 키워드 ▸ 괄호로 묶고 연산자 이동
중위식을 후위식·전위식으로 바꾸는 문제는 거의 매회 나옵니다. 예제: A + B * C − D
| 단계 | 방법 | 결과 |
| 1단계 | 연산 우선순위대로 괄호로 묶기 (곱셈·나눗셈 먼저) | ((A + (B * C)) − D) |
| 2단계 · 후위식 | 각 연산자를 자기 괄호의 오른쪽 밖으로 옮기고 괄호 삭제 | A B C * + D − |
| 2단계 · 전위식 | 각 연산자를 자기 괄호의 왼쪽 밖으로 옮기고 괄호 삭제 | − + A * B C D |
| 거꾸로 (후위 → 중위) | '피연산자 2개 + 연산자' 묶음을 찾아 연산자를 가운데로 옮기며 괄호로 묶음 | A B C * + → A + (B * C) |
정렬 알고리즘
암기 키워드 ▸ 삽선버 n² / 퀵힙병 n log n
| 정렬 | 방식 | 평균 | 최악 |
| 삽입 정렬 | 두 번째 원소부터, 앞쪽의 이미 정렬된 부분에서 알맞은 자리를 찾아 끼워 넣음 | O(n²) | O(n²) |
| 선택 정렬 | 남은 원소 중 최솟값을 찾아 맨 앞 원소와 교환하는 것을 반복 | O(n²) | O(n²) |
| 버블 정렬 | 이웃한 두 원소를 비교해 교환. 한 회전이 끝나면 가장 큰 값이 맨 뒤로 감 | O(n²) | O(n²) |
| 쉘 정렬 | 일정 간격(h)만큼 떨어진 원소끼리 삽입 정렬하고 간격을 줄여 감 | O(n^1.5) | O(n²) |
| 퀵 정렬 | 피벗(기준값)보다 작은 쪽과 큰 쪽으로 나눈 뒤 각각 다시 정렬 (분할 정복) | O(n log n) | O(n²) |
| 힙 정렬 | 완전 이진 트리(힙)를 만들어 가장 큰(작은) 값부터 꺼냄 | O(n log n) | O(n log n) |
| 합병(병합) 정렬 | 반씩 계속 나눠 정렬한 뒤 합침 | O(n log n) | O(n log n) |
1회전 결과 예시 — [5, 3, 8, 1, 9]를 오름차순으로 정렬할 때
| 정렬 | 1회전 후 | 이유 |
| 선택 정렬 | [1, 3, 8, 5, 9] | 최솟값 1을 찾아 맨 앞의 5와 교환 |
| 버블 정렬 | [3, 5, 1, 8, 9] | 5↔3 교환, 8↔1 교환 → 가장 큰 값 9는 맨 뒤에 위치 |
| 삽입 정렬 | [3, 5, 8, 1, 9] | 두 번째 값 3을 앞쪽의 알맞은 자리(5 앞)에 삽입 |
시험 포인트 퀵 정렬만 '평균은 O(n log n)이지만 최악은 O(n²)'이라는 점이 단골 함정입니다.
검색과 해싱
암기 키워드 ▸ 이분 검색은 정렬 필수
| 용어 | 설명 |
| 순차 검색 | 처음부터 하나씩 비교. 정렬이 필요 없음, O(n) |
| 이분(이진) 검색 | 정렬된 자료에서 가운데 값과 비교해 범위를 절반씩 줄임, O(log n). 가운데 위치 = (시작 + 끝) ÷ 2 |
| 해싱 | 해시 함수로 키 값을 저장 주소로 바꿔 한 번에 접근 |
| 충돌 / 동의어 | 서로 다른 키가 같은 주소를 갖는 현상 / 같은 주소를 갖는 키들의 모임 |
| 해시 함수 종류 | 제산법(키를 소수로 나눈 나머지), 제곱법, 폴딩법(나눠서 더하기), 기수 변환법, 숫자 분석법, 무작위법 |
| 충돌 해결 | 개방 주소법(선형 탐사 등 빈자리 찾기), 체이닝(연결 리스트로 이어 붙이기), 재해싱 |
3. 애플리케이션 테스트
테스트의 기본 원리
| 용어 | 설명 |
| 결함 집중 | 결함의 대부분은 소수의 모듈에 몰려 있음 (파레토 법칙, 80:20) |
| 살충제 패러독스 | 같은 테스트를 반복하면 새로운 결함을 못 찾음 → 테스트 케이스를 주기적으로 바꿔야 함 |
| 오류-부재의 궤변 | 결함을 다 고쳐도 사용자의 요구를 못 채우면 좋은 소프트웨어가 아님 |
| 완벽한 테스트는 불가능 | 모든 경우를 다 테스트할 수는 없음 → 위험도에 따라 우선순위를 둠 |
| 초기 집중 | 개발 초기부터 테스트할수록 결함을 고치는 비용이 적게 듦 |
| 정황 의존 | 소프트웨어의 특징과 환경에 맞게 테스트를 다르게 해야 함 |
| 결함 존재 증명 | 테스트는 결함이 '있다'는 건 보여 줄 수 있지만 '없다'는 건 증명할 수 없음 |
테스트 레벨과 V-모델
암기 키워드 ▸ 단통시인
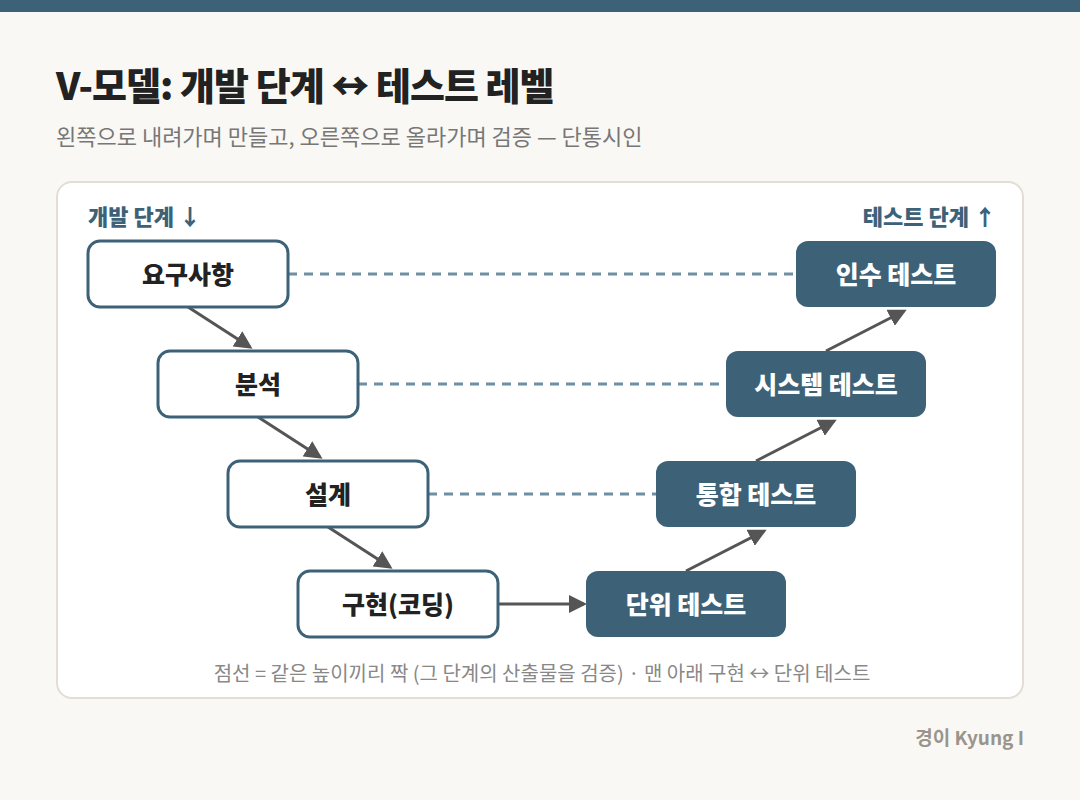
테스트는 작은 단위에서 큰 단위로 진행합니다. V-모델은 왼쪽의 개발 단계와 오른쪽의 테스트 단계를 같은 높이끼리 짝지은 모델이에요.
| 용어 | 설명 |
| 단위 테스트 | 모듈(함수·클래스) 하나를 따로 검사. 주로 화이트박스 기법 사용 — 구현(코딩) 단계와 짝 |
| 통합 테스트 | 모듈을 합치면서 모듈 사이의 인터페이스 결함을 검사 — 설계 단계와 짝 |
| 시스템 테스트 | 완성된 시스템 전체의 기능·성능·보안을 실제와 비슷한 환경에서 검사 — 분석 단계와 짝 |
| 인수 테스트 | 사용자가 요구사항을 충족하는지 확인하고 넘겨받는(인수) 테스트 — 요구사항 단계와 짝 |
시험 포인트 V-모델 짝: 요구사항 ↔ 인수, 분석 ↔ 시스템, 설계 ↔ 통합, 구현 ↔ 단위 (수험서 기준).
인수 테스트의 종류
암기 키워드 ▸ 알파 / 베타
| 용어 | 설명 |
| 알파 테스트 | 개발자의 장소에서 사용자가 테스트하고, 개발자가 옆에서 지켜봄 (통제된 환경) |
| 베타 테스트 | 사용자의 실제 환경에서 사용자가 직접 테스트, 개발자는 없음 (필드 테스트). 발견한 오류는 기록해서 개발자에게 전달 |
| 그 밖의 인수 테스트 | 사용자 인수, 운영상 인수, 계약 인수, 규정 인수 테스트 |
통합 테스트 방식
암기 키워드 ▸ 상드하스
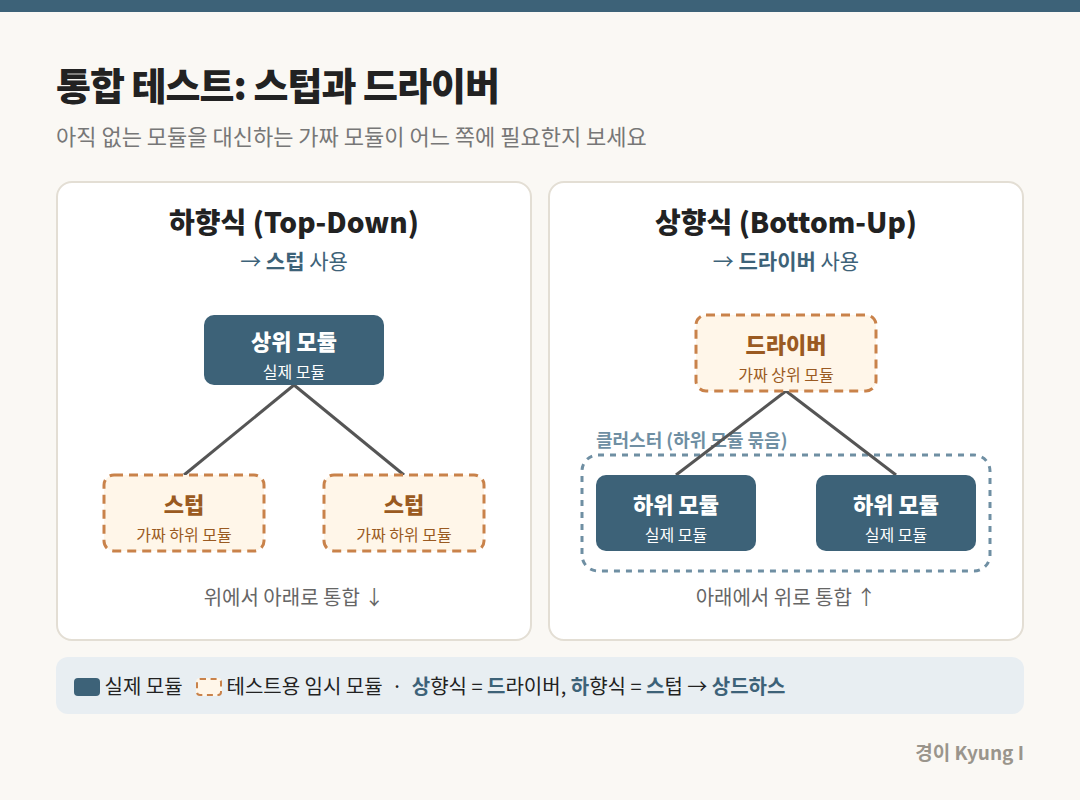
모듈을 어떤 순서로 합치느냐에 따라 필요한 임시 모듈이 달라집니다. '상향식 = 드라이버, 하향식 = 스텁'이 핵심이에요.
| 용어 | 설명 |
| 하향식 (Top-Down) | 상위 모듈부터 아래로 내려가며 통합. 아직 없는 하위 모듈 대신 '스텁(Stub)'을 씀. 깊이 우선·너비 우선 방식 |
| 상향식 (Bottom-Up) | 가장 아래 모듈부터 위로 올라가며 통합. 하위 모듈을 묶은 '클러스터'와, 상위 모듈을 대신하는 '드라이버(Driver)'를 씀 |
| 스텁 (Stub) | 아직 없는 하위 모듈을 흉내 내는 임시 모듈 (호출당하는 쪽) |
| 드라이버 (Driver) | 상위 모듈 대신 테스트 대상을 호출해 주는 임시 모듈 (호출하는 쪽) |
| 빅뱅 / 샌드위치 | 모든 모듈을 한꺼번에 통합(결함 위치 찾기 어려움) / 하향식과 상향식을 함께 사용 |
| 회귀 테스트 | 수정하거나 통합한 뒤, 기존 기능에 새로운 오류가 생기지 않았는지 다시 확인 |
화이트박스 테스트
암기 키워드 ▸ 기초 경로 · 제어 구조
코드 안의 논리 흐름을 직접 보면서 테스트합니다. 모든 경로를 최소 한 번씩 실행해 보는 것이 목표예요.
| 용어 | 설명 |
| 기초 경로 검사 | 맥케이브(McCabe)의 순환 복잡도로 독립적인 경로 수를 구하고, 그 경로를 모두 테스트 |
| 순환 복잡도 계산 | V(G) = E − N + 2 (E: 간선 수, N: 노드 수) = 제어 흐름 그래프에서 나뉘는 영역의 수 |
| 조건 검사 | 프로그램 안의 논리적 조건을 테스트 |
| 루프 검사 | 반복 구조에 초점을 맞춰 테스트 |
| 데이터 흐름 검사 | 변수가 정의된 위치와 사용된 위치를 따라가며 테스트 |
예시
노드 8개, 간선 10개인 제어 흐름 그래프 → V(G) = 10 − 8 + 2 = 4 → 독립 경로 4개
테스트 커버리지 (화이트박스 검증 기준)
코드를 얼마나 빠짐없이 실행했는지 재는 기준입니다. 아래로 갈수록 대체로 더 엄격해요.
| 용어 | 설명 |
| 구문(문장) 커버리지 | 모든 문장을 최소 한 번 실행 |
| 결정(분기) 커버리지 | 각 결정문(if 등)의 전체 결과가 참·거짓을 최소 한 번씩 |
| 조건 커버리지 | 결정문 안의 개별 조건식이 참·거짓을 최소 한 번씩 |
| 조건/결정 커버리지 | 개별 조건과 전체 결정이 모두 참·거짓을 최소 한 번씩 |
| 변경 조건/결정 (MC/DC) | 각 개별 조건이 다른 조건과 상관없이 전체 결과에 독립적으로 영향을 주는지 확인 |
| 다중 조건 커버리지 | 모든 조건의 가능한 조합을 전부 테스트 (가장 강력) |
블랙박스 테스트
암기 키워드 ▸ 동경원오비
프로그램 안은 보지 않고, 요구사항 명세서를 기준으로 입력과 출력만 보고 테스트합니다.
| 용어 | 설명 |
| 동치(동등) 분할 | 입력값을 유효·무효 그룹으로 나누고 그룹마다 대표값을 테스트. 예) 점수 0~100 → 50(유효), −5·120(무효) |
| 경계값 분석 | 오류가 경계에서 많이 난다는 점을 이용해 경계값의 바로 위·아래를 테스트. 예) −1, 0, 100, 101 |
| 원인-효과 그래프 | 입력 조건(원인)과 출력(효과)의 관계를 그래프로 그려 테스트 케이스를 뽑음 |
| 오류 예측 | 테스터의 경험과 감으로 오류가 날 만한 곳을 테스트 (다른 기법을 보충) |
| 비교 검사 | 같은 테스트 데이터를 여러 버전의 프로그램에 넣고 결과를 비교 |
| 그 밖의 기법 | 결정 테이블, 상태 전이, 유스케이스, 분류 트리, 페어와이즈 테스트 |
테스트 오라클
암기 키워드 ▸ 참샘휴일
테스트 결과가 맞는지 판단하는 기준(참값)입니다.
| 용어 | 설명 |
| 참 (True) 오라클 | 모든 입력값에 대해 기대 결과를 제공 → 발생한 모든 오류를 찾을 수 있음 |
| 샘플링 오라클 | 특정한 몇 개의 입력값에 대해서만 기대 결과를 제공 |
| 휴리스틱(추정) 오라클 | 특정 입력값에는 기대 결과를 주고, 나머지는 추정으로 판단 |
| 일관성 검사 오라클 | 프로그램을 바꾼 뒤에도 결과가 전과 같은지 확인 (회귀 테스트에 활용) |
테스트 하네스 구성 요소
테스트를 돕기 위해 만드는 코드와 데이터를 통틀어 테스트 하네스라고 합니다.
| 용어 | 설명 |
| 테스트 드라이버 | 테스트 대상의 상위 모듈을 대신해 호출하는 도구 |
| 테스트 스텁 | 테스트 대상의 하위 모듈을 대신하는 도구 |
| 테스트 슈트 | 테스트 케이스들을 묶어 놓은 것 |
| 테스트 케이스 | 입력값, 실행 조건, 기대 결과로 이루어진 테스트 항목 명세 |
| 테스트 스크립트 | 자동화된 테스트 실행 절차를 적은 명세 |
| 목 오브젝트 (Mock Object) | 미리 정해 둔 행동만 하는 가짜 객체 |
4. 품질 · 형상 관리 · 인터페이스
ISO/IEC 9126 품질 특성
암기 키워드 ▸ 기신사효유이
| 용어 | 설명 |
| 기능성 | 요구한 기능을 정확히 제공 (적합성, 정확성, 상호 운용성, 보안성) |
| 신뢰성 | 정해진 조건에서 오류 없이 동작 (성숙성, 고장 허용성, 회복성) |
| 사용성 | 쉽게 이해하고 배우고 쓸 수 있음 (이해성, 학습성, 운용성) |
| 효율성 | 자원을 적게 쓰면서 빠르게 동작 (시간 효율성, 자원 효율성) |
| 유지보수성 | 고치고 개선하기 쉬움 (분석성, 변경성, 안정성, 시험성) |
| 이식성 | 다른 환경으로 옮겨도 잘 동작 (적응성, 설치성, 대체성, 공존성) |
시험 포인트 개정판인 ISO/IEC 25010은 호환성과 보안성을 따로 떼어 8가지(기능 적합성, 성능 효율성, 호환성, 사용성, 신뢰성, 보안성, 유지보수성, 이식성)입니다.
형상 관리
암기 키워드 ▸ 식통감기
개발하면서 생기는 코드·문서 같은 산출물의 변경을 체계적으로 관리하는 활동입니다.
| 용어 | 설명 |
| ① 형상 식별 | 관리할 대상을 정하고 이름과 버전을 붙임 |
| ② 형상 통제 | 변경 요청을 검토·승인해 기준선(베이스라인)에 반영. 형상 통제 위원회(CCB)가 담당 |
| ③ 형상 감사 | 기준선 변경이 제대로 되었는지 검토하고 확인 |
| ④ 형상 기록(보고) | 변경 내용을 기록하고 보고 |
| 기준선 (Baseline) | 정식으로 검토·합의되어 이후 변경의 기준이 되는 산출물 |
버전 관리 도구
| 용어 | 설명 |
| 공유 폴더 방식 | 파일을 공유 폴더에 복사해서 관리 (RCS, SCCS) |
| 클라이언트/서버 방식 | 중앙 서버의 저장소 하나에 모든 버전을 저장 (CVS, SVN) |
| 분산 저장소 방식 | 원격 저장소와 개인 로컬 저장소를 따로 두고, 로컬에서 먼저 커밋한 뒤 원격에 반영 (Git, Bitkeeper) |
| 주요 용어 | 저장소(Repository), 체크아웃(저장소에서 가져오기), 커밋(변경 내용 반영), 브랜치(분기), 병합(Merge) |
빌드 자동화 도구
| 용어 | 설명 |
| Ant | 아파치 재단이 만든 자바 빌드 도구. XML 기반, 정해진 규칙이 없어 자유로움 |
| Maven | 아파치 재단. 의존성(라이브러리) 관리가 강점, pom.xml로 설정 |
| Gradle | Groovy 기반 빌드 도구. 안드로이드 앱의 기본 빌드 도구 |
| Jenkins | 자바 기반의 지속적 통합(CI) 서버. 빌드·테스트를 자동으로 반복 실행 |
클린 코드 (소스 코드 품질)
암기 키워드 ▸ 가단의중추
| 용어 | 설명 |
| 가독성 | 누구나 쉽게 읽을 수 있게 작성 (들여쓰기, 이해하기 쉬운 이름) |
| 단순성 | 한 번에 한 가지 일만 하도록, 클래스·메서드를 작은 단위로 나눔 |
| 의존성 배제 | 다른 모듈에 주는 영향을 최소화 |
| 중복성 최소화 | 중복된 코드는 없애고 공통 코드를 사용 |
| 추상화 | 상위 클래스·메서드는 특징만 간단히, 세부 구현은 하위에서 |
| 나쁜 코드 예 | 스파게티 코드(흐름이 뒤엉킨 코드), 외계인 코드(너무 오래되어 유지보수가 어려운 코드) |
인터페이스 구현 (EAI · 데이터 포맷 · 보안)
암기 키워드 ▸ 포허메하
EAI는 기업 안의 서로 다른 애플리케이션을 연결해 주는 솔루션입니다. 연결 방식 4가지를 묻습니다.
| 용어 | 설명 |
| Point-to-Point | 애플리케이션끼리 1:1로 직접 연결. 단순하지만 재사용이 어려움 |
| Hub & Spoke | 가운데 허브를 거쳐 연결. 확장은 쉽지만 허브에 장애가 나면 전체가 영향받음 |
| Message Bus (ESB 방식) | 애플리케이션 사이에 미들웨어(버스)를 두고 연결. 확장성이 뛰어남 |
| Hybrid | 그룹 안은 Hub & Spoke, 그룹 사이는 Message Bus |
| 데이터 포맷 | JSON(속성-값 쌍, 가벼움), XML(태그 기반), YAML / AJAX: 페이지 전체가 아니라 필요한 부분만 비동기로 갱신 |
| 인터페이스 보안 | IPSec(네트워크 계층), SSL/TLS(전송 계층), S-HTTP(응용 계층) |
디지털 저작권 관리(DRM) 구성 요소
제품 소프트웨어 패키징 단원에서 나오는 내용입니다.
| 용어 | 설명 |
| 클리어링 하우스 | 저작권 사용 권한, 라이선스 발급, 결제를 관리 |
| 콘텐츠 제공자 | 콘텐츠를 만든 저작권자 |
| 패키저 | 콘텐츠를 메타데이터와 함께 배포할 수 있는 형태로 묶고 암호화 |
| 콘텐츠 분배자 | 쇼핑몰처럼 콘텐츠를 유통하는 곳 |
| 보안 컨테이너 | 원본을 안전하게 유통하기 위한 전자적 보안 장치 |
| DRM 컨트롤러 | 콘텐츠 이용 권한을 통제 |
5. 헷갈리지 않게 외우는 요령
- 통합 테스트는 '상드하스' 하나로 끝납니다. 위에서부터 내려오면(하향식) 아래 모듈이 아직 없으니 가짜 '스텁'을, 아래에서부터 올라가면(상향식) 불러 줄 위 모듈이 없으니 '드라이버'를 만든다고 이해하면 거꾸로 외울 일이 없어요.
- 화이트박스는 '투명한 상자'라 속(코드)이 보이니까 경로·조건·루프를 보고, 블랙박스는 속이 안 보이니까 '어떤 입력값을 넣을까'(동치 분할·경계값…)를 고민한다고 나누면 기법 이름이 섞이지 않습니다.
- 트리 순회와 표기법 변환은 외우는 게 아니라 푸는 문제입니다. 이 글의 예제를 종이에 한 번씩 직접 풀어 보면 시험장에서 바로 손이 나가요.
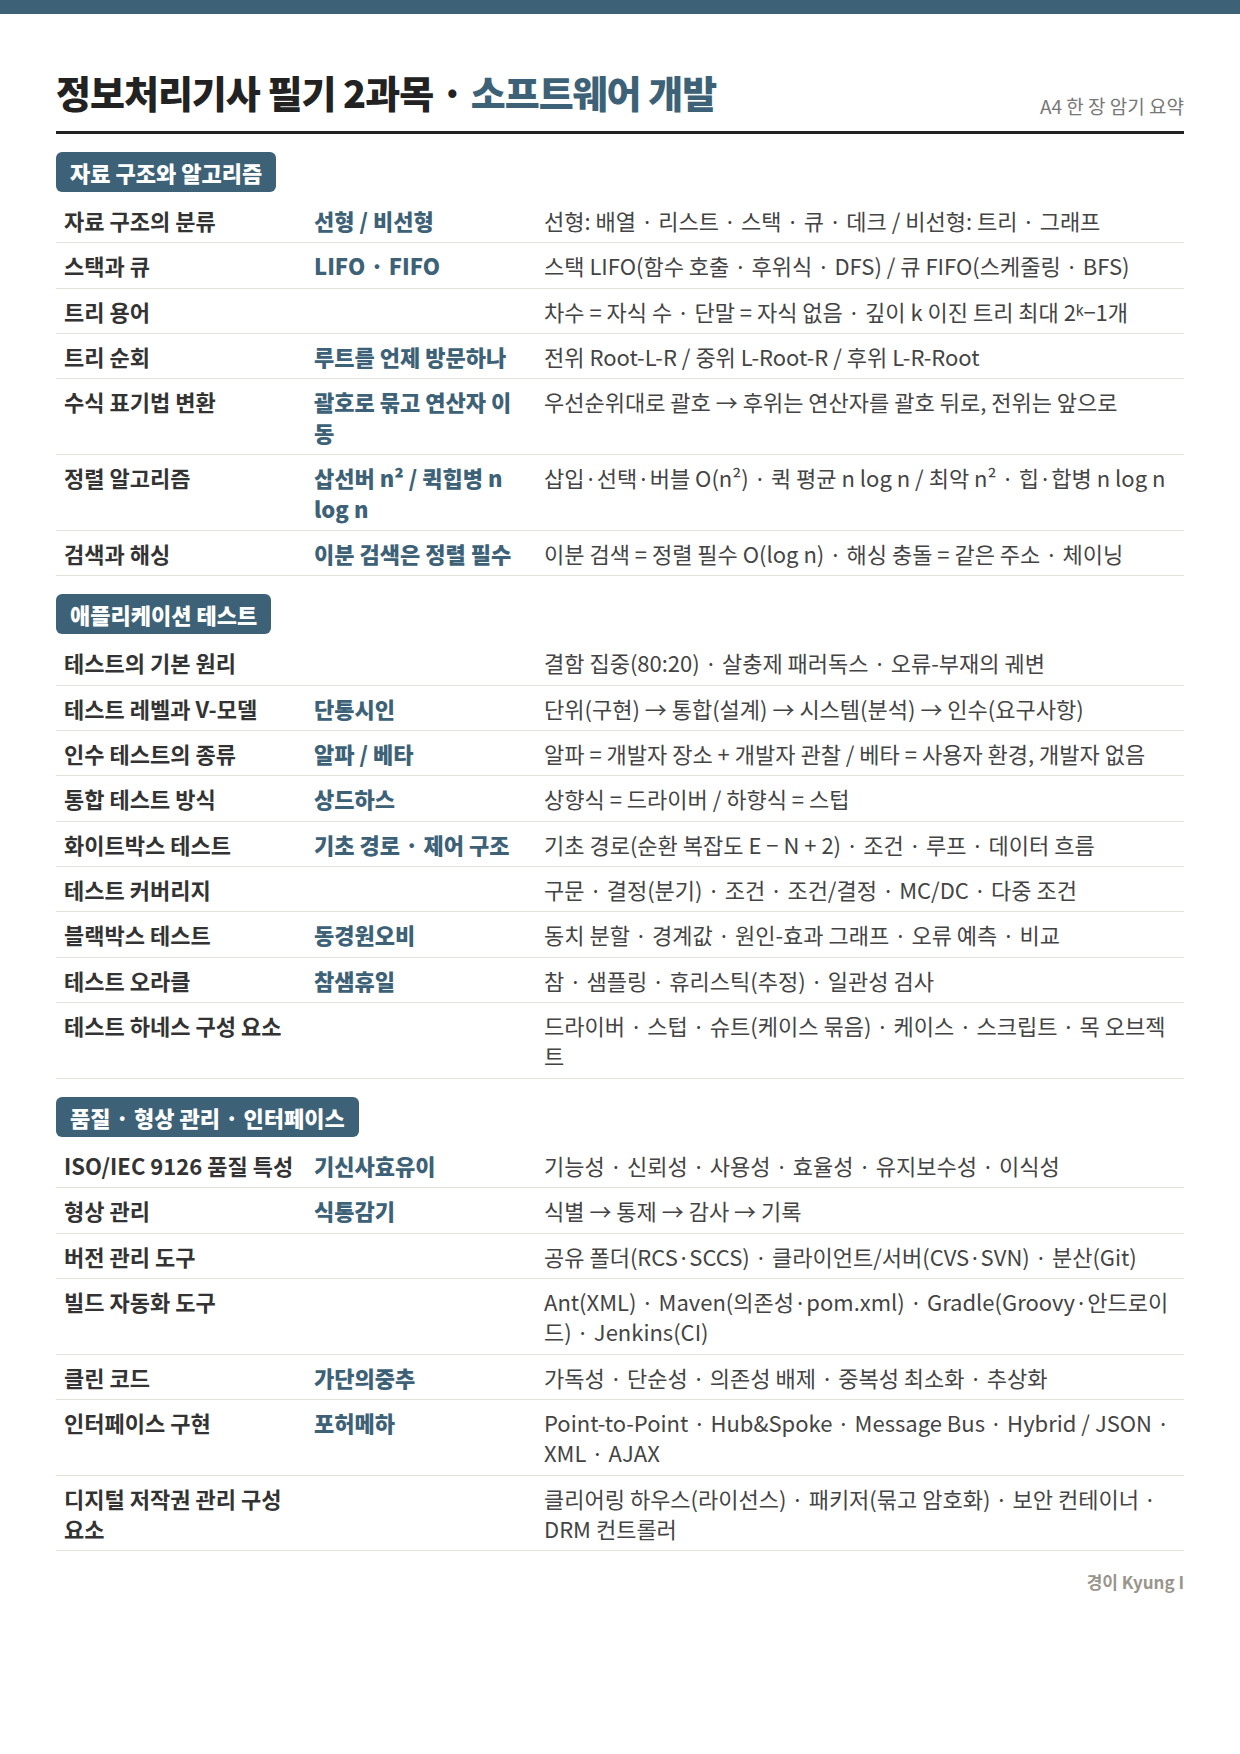
6. A4 한 장 요약본
위 내용을 키워드만 남겨 A4 한 장으로 줄였습니다. 이미지를 저장해서 출력하거나 휴대폰에 넣어 두고 시험 직전에 훑어보세요.
마무리
두문자는 뜻을 모른 채 외우면 금방 잊힙니다. 키워드 → 풀어 쓰기 → 기출 한 문제 순서로 이어 두면 필기는 물론 실기 단답형까지 그대로 연결돼요. 나머지 과목 암기 총정리도 같은 형식으로 정리해 두었습니다.
※ 두문자는 수험생들 사이에서 흔히 쓰는 암기 요령이며, 표현은 수험서마다 조금씩 다를 수 있습니다. 세부 출제기준은 Q-net 공지로 최종 확인하세요.
'자격증' 카테고리의 다른 글
| 정보처리기사 4과목 프로그래밍 언어 활용 암기 총정리 | 두문자·용어 설명·그림으로 한 번에 (0) | 2026.09.29 |
|---|---|
| 정보처리기사 3과목 데이터베이스 구축 암기 총정리 | 두문자·용어 설명·그림으로 한 번에 (0) | 2026.09.29 |
| 정보처리기사 1과목 소프트웨어 설계 암기 총정리 | 두문자·용어 설명·그림으로 한 번에 (0) | 2026.09.29 |
| 네트워크관리사 2급 시험 과목 총정리 | 필기 4과목·실기 출제 유형과 공부법 (2026) (0) | 2026.09.28 |
| 리눅스마스터 2급 시험 과목 총정리 | 1차·2차 출제범위, 필수 명령어와 공부법 (2026) (0) | 2026.09.28 |


댓글